

Ghost 文章觀看數怎麼做?用 Cloudflare Workers 和 D1 自架計數器
驗證於
本文目錄
用 WordPress 的人換到 Ghost,常會發現一件事:文章頁沒有「幾次觀看」。Ghost 6 的原生分析要接 Tinybird,數字只顯示在後台,主題讀不到;自架時想把 Tinybird 也搬到自己機器上,Tinybird Local 的官方定位又是開發用的隔離環境,不適合拿來跑正式站。
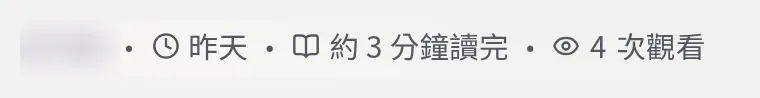
如果網站本來就放在 Cloudflare 後面,比較省事的做法是自己用 Cloudflare Workers 加 D1 做一個計數器:Worker 掛在同網域的 /api/views 路徑,D1 存每篇文章的累計數字,主題用一小段 JavaScript 讀寫。做完的效果像這樣,文章日期和閱讀時間後面多一個「N 次觀看」:
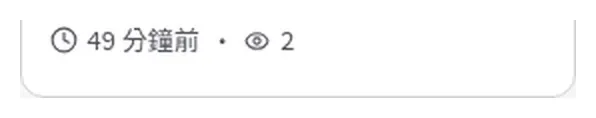
首頁和列表的文章卡片也會顯示,0 次的就不顯示:
以下用 example.com 當網站網域、views-db 當 D1 資料庫、view-counter 當 Worker 名稱,實際部署時換成自己的。
整體架構:Worker 只接 /api/views
| 元件 | 做什麼 |
|---|---|
D1 views 表 | 每篇文章一列,存累計觀看數 |
D1 seen 表 | 記錄 30 分鐘內看過的訪客,用來去重 |
Worker 路由 example.com/api/views* | 只處理計數 API,不碰 Ghost 的 /ghost/api |
| 主題 JavaScript | 文章頁送 POST 加 1,列表頁批次 GET 讀數字 |
三個 API 端點:
POST /api/views/:slug:加 1,回傳最新數字。GET /api/views/:slug:讀單篇的數字。GET /api/views?slugs=a,b,c:一次讀多篇,給列表卡片用,回應快取 60 秒。
為什麼掛同網域,而不是用 workers.dev
Worker 預設會有一個 *.workers.dev 網址。計數器改用網站自己的路徑,好處有兩個:瀏覽器送的是同源請求,不用處理 CORS;而且 example.com/api/views 看起來就是網站本身的 API,比第三方網域不容易被廣告攔截外掛擋掉。部署時也順便把 workers.dev 網址關掉,避免有人繞過網域檢查直接打。
依 Cloudflare Routes 文件,路由只能加在 DNS 有開 Cloudflare 代理(橘色雲朵)的主機名稱上,網站本來就在 Cloudflare 後面的話,這個條件已經滿足。
為什麼用 D1,不用 KV
計數器最怕的是同時有好幾個人打開同一篇文章。KV 沒有原子操作,只能「讀出數字、加 1、寫回去」,兩個請求同時讀到 10,就會都寫回 11,少算一次。依 Cloudflare KV 文件,KV 是最終一致的儲存,官方也寫明不適合需要原子操作的用途;同一個 key 每秒也只能寫入 1 次。
D1 是 SQLite,可以用一行 SQL 在資料庫裡直接加 1,並發時也不會少算:
INSERT INTO views (slug, count, updated_at) VALUES (?1, 1, ?2)ON CONFLICT(slug) DO UPDATE SET count = count + 1, updated_at = excluded.updated_atRETURNING count;建立 D1 資料庫和資料表
先用 Wrangler 建資料庫:
npx wrangler d1 create views-db建好後會拿到一組 database ID,等一下要填進設定檔。接著建立 schema.sql:
CREATE TABLE IF NOT EXISTS views ( slug TEXT PRIMARY KEY, count INTEGER NOT NULL DEFAULT 0, updated_at INTEGER NOT NULL);
CREATE TABLE IF NOT EXISTS seen ( h TEXT PRIMARY KEY, ts INTEGER NOT NULL);views 存每篇文章的累計數字;seen 存「訪客 + 文章」的雜湊值和最後計數的時間,用來判斷 30 分鐘內是不是同一個人重看。把資料表建到線上的資料庫:
npx wrangler d1 execute views-db --remote --file=schema.sqlWorker 程式碼
完整的 worker.js。SITE_HOSTS 和 SITE_ORIGIN 換成自己的網域:
// view-counter: per-article view counter for a Ghost site (Workers + D1)const SITE_ORIGIN = "https://example.com";const SITE_HOSTS = new Set(["example.com", "www.example.com"]);const SLUG_RE = /^[a-z0-9-]{1,190}$/;const BOT_RE = /bot|crawl|spider|slurp|scrap|preview|facebookexternalhit|embedly|headless|phantom|puppeteer|playwright|selenium|lighthouse|pagespeed|python|curl|wget|httpie|axios|node-fetch|undici|go-http|okhttp|java\/|libwww|postman|insomnia|monitor|uptime|pingdom/i;const DEDUPE_SEC = 30 * 60;const GET_TTL = 60;
const json = (obj, status = 200, extra = {}) => new Response(JSON.stringify(obj), { status, headers: { "content-type": "application/json; charset=utf-8", "x-robots-tag": "noindex", ...extra }, });
// Only accept requests whose Origin (or Referer) is this site.function sameOrigin(req) { for (const h of ["origin", "referer"]) { const v = req.headers.get(h); if (!v) continue; try { return SITE_HOSTS.has(new URL(v).hostname); } catch { return false; } } return false;}
// IPv6 users rotate addresses inside their /64, so dedupe on the /64 prefix.function ipKey(ip) { if (!ip.includes(":")) return ip; const [head, tail = ""] = ip.split("::"); const h = head ? head.split(":") : [], t = tail ? tail.split(":") : []; const full = ip.includes("::") ? [...h, ...Array(8 - h.length - t.length).fill("0"), ...t] : h; return full.slice(0, 4).map((g) => g.toLowerCase().replace(/^0+(?=.)/, "")).join(":") + "::/64";}
async function sha256(s) { const buf = await crypto.subtle.digest("SHA-256", new TextEncoder().encode(s)); return [...new Uint8Array(buf)].map((b) => b.toString(16).padStart(2, "0")).join("");}
async function getCount(env, slug) { const row = await env.DB.prepare("SELECT count FROM views WHERE slug = ?").bind(slug).first(); return row ? row.count : 0;}
// Only checked the first time a slug is seen, so junk slugs can't fill the table.async function postExists(slug) { const r = await fetch(`${SITE_ORIGIN}/${slug}/`, { method: "HEAD", redirect: "manual", headers: { "user-agent": "view-counter-check" }, cf: { cacheTtl: 300, cacheEverything: true }, }); return r.status === 200;}
async function increment(req, env, ctx, slug) { if (!sameOrigin(req)) return json({ error: "forbidden" }, 403); const ua = req.headers.get("user-agent") || ""; if (!ua || BOT_RE.test(ua)) return json({ slug, count: await getCount(env, slug), counted: false });
const now = Math.floor(Date.now() / 1000); const existing = await env.DB.prepare("SELECT count FROM views WHERE slug = ?").bind(slug).first(); if (!existing && !(await postExists(slug))) return json({ error: "not_found" }, 404);
const ip = req.headers.get("cf-connecting-ip") || "0"; const h = await sha256(`${env.IP_SALT}|${ipKey(ip)}|${ua}|${slug}`); const seen = await env.DB.prepare( "INSERT INTO seen (h, ts) VALUES (?1, ?2) ON CONFLICT(h) DO UPDATE SET ts = excluded.ts WHERE seen.ts < ?3" ).bind(h, now, now - DEDUPE_SEC).run();
let count, counted = false; if (seen.meta.changes > 0) { const row = await env.DB.prepare( "INSERT INTO views (slug, count, updated_at) VALUES (?1, 1, ?2) ON CONFLICT(slug) DO UPDATE SET count = count + 1, updated_at = excluded.updated_at RETURNING count" ).bind(slug, now).first(); count = row.count; counted = true; } else { count = existing ? existing.count : 0; } // Occasionally clean up expired dedupe rows. if (Math.random() < 0.02) { ctx.waitUntil(env.DB.prepare("DELETE FROM seen WHERE ts < ?").bind(now - DEDUPE_SEC).run()); } return json({ slug, count, counted }, 200, { "cache-control": "no-store" });}
async function cachedGet(req, ctx, producer) { const cache = caches.default; const key = new Request(new URL(req.url).toString(), { method: "GET" }); const hit = await cache.match(key); if (hit) return hit; const res = json(await producer(), 200, { "cache-control": `public, max-age=${GET_TTL}` }); ctx.waitUntil(cache.put(key, res.clone())); return res;}
export default { async fetch(req, env, ctx) { const url = new URL(req.url); const path = url.pathname.replace(/\/+$/, ""); if (!path.startsWith("/api/views")) return fetch(req); // safety: pass through anything else
if (path === "/api/views") { if (req.method !== "GET") return json({ error: "method_not_allowed" }, 405, { allow: "GET" }); const slugs = [...new Set((url.searchParams.get("slugs") || "").split(",").map((s) => s.trim()).filter(Boolean))]; if (!slugs.length || slugs.length > 60 || !slugs.every((s) => SLUG_RE.test(s))) return json({ error: "bad_slugs" }, 400); return cachedGet(req, ctx, async () => { const { results } = await env.DB.prepare( `SELECT slug, count FROM views WHERE slug IN (${slugs.map(() => "?").join(",")})` ).bind(...slugs).all(); const counts = Object.fromEntries(slugs.map((s) => [s, 0])); for (const r of results) counts[r.slug] = r.count; return { counts }; }); }
const m = path.match(/^\/api\/views\/([^/]+)$/); if (!m || !SLUG_RE.test(m[1])) return json({ error: "bad_slug" }, 400); const slug = m[1]; if (req.method === "POST") return increment(req, env, ctx, slug); if (req.method === "GET" || req.method === "HEAD") return cachedGet(req, ctx, async () => ({ slug, count: await getCount(env, slug) })); return json({ error: "method_not_allowed" }, 405, { allow: "GET, POST" }); },};幾個關鍵段落:
- 原子累加:真正加 1 的只有
INSERT … ON CONFLICT … RETURNING count那一句,數字在資料庫裡算好再回傳。 - 去重:
seen表的INSERT … ON CONFLICT(h) DO UPDATE … WHERE seen.ts < ?3只有在「第一次看」或「上次計數超過 30 分鐘」時才會改到資料,meta.changes > 0才去加 1。 - 清理:過期的去重紀錄不用排程清,每次計數有 2% 的機率順手刪掉,用
ctx.waitUntil在回應之後執行,不拖慢回應。 - 批次讀取:一次最多 60 篇,超過或格式不對直接回 400;回應用 Cache API 快取 60 秒,列表頁被很多人看時不會每次都查 D1。
防灌水:擋掉大部分「不是真人在看」的請求
計數 API 是公開的,任何人都能對它送 POST。上面的程式碼用了幾層檢查:
- slug 格式:只接受
^[a-z0-9-]{1,190}$,也就是 Ghost 預設的網址代稱格式。 - 文章要真的存在:資料庫裡還沒有這個 slug 時,先對
https://example.com/<slug>/送 HEAD,回 200 才寫入。這樣亂打的 slug 不會塞滿資料表;這個檢查假設文章網址是 Ghost 預設的/<slug>/,有改過網址結構的要跟著調整。 - 只收本站來的請求:Origin 或 Referer 不是自己網域的,回 403。瀏覽器送同源的 POST 時會自動帶 Origin,正常讀者不受影響。
- 過濾爬蟲和工具:User-Agent 是空的,或含 bot、curl、python、headless、puppeteer、lighthouse 這類字串的,照樣回傳數字,但不計數。
- 同一位訪客 30 分鐘只算一次:用「鹽值 + IP + User-Agent + slug」做 SHA-256 雜湊,資料庫只存雜湊值,不存原始 IP。IPv6 取前 64 位元的網段,因為手機的 IPv6 位址常在同一個網段裡換來換去,用完整位址會一直被當成新訪客。
要知道的是,Origin 和 User-Agent 都能被程式偽造,這些檢查擋的是爬蟲和隨手灌水,不是刻意攻擊。觀看數本來就是給讀者參考的數字,不要拿來當計費或排名的依據。
設定檔與部署
wrangler.toml:
name = "view-counter"main = "worker.js"compatibility_date = "2026-11-01"account_id = "YOUR_ACCOUNT_ID"
# Only serve on the site's own domainworkers_dev = falsepreview_urls = false
routes = [ { pattern = "example.com/api/views*", zone_name = "example.com" }]
[[d1_databases]]binding = "DB"database_name = "views-db"database_id = "YOUR_DATABASE_ID"workers_dev = false 會關掉 workers.dev 網址,preview_urls = false 關掉預覽網址。有 www.example.com 也會被讀者用到的話,再加一條 www.example.com/api/views* 的路由。
鹽值不要寫進程式碼或設定檔,用 secret 存。先產生一組隨機字串,再設成 IP_SALT:
openssl rand -hex 32npx wrangler secret put IP_SALTnpx wrangler deploy鹽值設好之後就不要再換,換了之後所有人的雜湊都會變,30 分鐘內重看會被多算一次(影響不大,但沒必要)。
主題:在文章頁顯示「N 次觀看」
文章頁
在 post.hbs 裡,日期和閱讀時間的後面加上這段。圖示用的是 Lucide 的 eye:
<span class="post-views" data-views-post data-views-slug="{{slug}}" hidden> <svg xmlns="http://www.w3.org/2000/svg" width="16" height="16" viewBox="0 0 24 24" fill="none" stroke="currentColor" stroke-width="2" stroke-linecap="round" stroke-linejoin="round" aria-hidden="true"> <path d="M2.062 12.348a1 1 0 0 1 0-.696 10.75 10.75 0 0 1 19.876 0 1 1 0 0 1 0 .696 10.75 10.75 0 0 1-19.876 0"/> <circle cx="12" cy="12" r="3"/> </svg> <span class="post-views-count"></span> 次觀看</span>預設加上 hidden,拿到數字才顯示。API 掛掉、超過免費額度或被外掛擋掉時,讀者只會看到原本的日期和閱讀時間,不會出現「0 次觀看」或錯誤訊息。
列表卡片
首頁、標籤頁的卡片(通常在 partials/post-card.hbs)加上類似的標記,只是改成 data-views-card:
<span class="post-views" data-views-card data-views-slug="{{slug}}" hidden> <svg ...同上...></svg> <span class="post-views-count"></span></span>JavaScript
放在主題的 JS 檔,或 default.hbs 的 {{ghost_foot}} 前面:
(() => { const API = "/api/views"; const TTL = 30 * 60 * 1000; // Don't count Ghost previews (/p/<uuid>/) or pages shown inside the admin iframe. const isPreview = location.pathname.startsWith("/p/") || window.self !== window.top;
const show = (el, n) => { if (!n) return; // 0 or missing: keep hidden el.querySelector(".post-views-count").textContent = n.toLocaleString(); el.hidden = false; };
// Article page: POST once per 30 minutes, otherwise just read. const post = document.querySelector("[data-views-post]"); if (post) { const slug = post.dataset.viewsSlug; const key = `viewed:${slug}`; let recent = false; try { recent = Date.now() - Number(localStorage.getItem(key) || 0) < TTL; } catch {} const shouldCount = !isPreview && !recent; fetch(`${API}/${slug}`, { method: shouldCount ? "POST" : "GET" }) .then((r) => (r.ok ? r.json() : null)) .then((d) => { if (!d) return; if (shouldCount) { try { localStorage.setItem(key, String(Date.now())); } catch {} } show(post, d.count); }) .catch(() => {}); }
// List cards: batch GET, up to 60 slugs per request. const cards = [...document.querySelectorAll("[data-views-card]")]; const slugs = [...new Set(cards.map((el) => el.dataset.viewsSlug))]; for (let i = 0; i < slugs.length; i += 60) { const batch = slugs.slice(i, i + 60); fetch(`${API}?slugs=${batch.join(",")}`) .then((r) => (r.ok ? r.json() : null)) .then((d) => { if (!d) return; cards.forEach((el) => { const n = d.counts[el.dataset.viewsSlug]; if (n !== undefined) show(el, n); }); }) .catch(() => {}); }})();瀏覽器端用 localStorage 記住 30 分鐘內看過的文章,這段時間內重新整理只會送 GET,不會送 POST,和伺服器端的去重是兩道關卡。
改完主題後打包上傳,或用自己平常更新主題的方式部署。
上線後怎麼測
用瀏覽器實際開一篇文章,再用 curl 測被擋的情況:
| 測試 | 預期結果 |
|---|---|
| 第一次打開文章 | 數字 +1,畫面出現「N 次觀看」 |
| 30 分鐘內重新整理 | 數字不變 |
curl -X POST https://example.com/api/views/some-post | 403,沒有 Origin |
加上 -H "Origin: https://other.example" | 403,不是本站 |
| 加上本站 Origin,但用 curl 預設的 User-Agent | 200,counted: false |
| 本站 Origin、一般瀏覽器 UA、不存在的 slug | 404,不會寫入資料庫 |
GET /api/views?slugs=a,b,c | 回傳 {"counts": {...}} |
也要確認原本的功能沒被影響:首頁、Ghost 後台、/sitemap.xml、RSS 都要能正常打開。Worker 只掛在 /api/views*,理論上不會碰到,但上線後實際點一輪比較安心。
有一個容易誤判的地方:如果測試環境每次連線的 IP 都不一樣(例如經過會輪替出口 IP 的代理或雲端瀏覽器),伺服器端的 30 分鐘去重看起來會「失效」,每次重新整理都 +1。這不是程式壞掉,而是每次都被當成新訪客。這段判斷要另外單獨測:從固定 IP 的電腦,清掉 localStorage 後連續送兩次 POST,第二次應該回 counted: false。
免費額度夠用嗎
依 Workers 限制文件和 D1 價格文件,Workers Free 的額度是:
| 項目 | 免費額度 |
|---|---|
| Workers 請求 | 每天 10 萬次 |
| D1 讀取列數 | 每天 500 萬列 |
| D1 寫入列數 | 每天 10 萬列 |
| D1 儲存空間 | 共 5 GB |
估算時注意三件事:
- Workers 的 10 萬次是整個帳號共用的,帳號裡還有其他 Worker 的話要一起算。每次打開文章是 1 次請求,每次打開列表頁也是 1 次請求;快取命中時仍會執行 Worker,一樣算請求。
- D1 算的是「列」不是「查詢」。 每次計入觀看會寫入
seen和views兩張表,再加上主鍵索引的更新,寫入列數會是計入次數的好幾倍,10 萬列寫入撐不到 10 萬次觀看。實際用量可以到 D1 資料庫的 Metrics → Row Metrics 查看。 - 每日額度在 00<00> UTC 重設,也就是台灣時間早上 8 點。
超過額度時,依官方文件,D1 會拒絕查詢;Workers 超過每日請求數時,路由可以設成 Fail open(略過 Worker)或 Fail closed(回 1027 錯誤頁)。不管哪一種,計數 API 都拿不到正常的 JSON,主題就維持隱藏,文章和其他頁面照常運作,只是暫時看不到觀看數。D1 超額的處理方式可以參考 Cloudflare D1 超過每日限制怎麼辦。
限制:數字從上線那天開始算
這個計數器沒有歷史資料,上線前的觀看次數都是 0。想讓舊文章有比較合理的起始數字,可以從 GA4 匯出各篇文章的瀏覽數,再寫進 D1:
INSERT INTO views (slug, count, updated_at)VALUES ('my-first-post', 1234, strftime('%s', 'now'))ON CONFLICT(slug) DO UPDATE SET count = count + excluded.count;把每篇文章整理成一行,存成 seed.sql 後執行 npx wrangler d1 execute views-db --remote --file=seed.sql。GA4 的「瀏覽」和這個計數器的算法不同(沒有 30 分鐘去重、也不過濾同一套 UA),匯入後的數字只能當參考的起點。
常見問題
Q: Ghost 6 有內建文章觀看數嗎?
A: 前台沒有。Ghost 6 的原生 Web Analytics 由 Tinybird 提供,數據顯示在 Ghost 後台,主題無法讀取並顯示在文章頁。自架時要啟用原生分析,官方說明需要用 Docker 安裝方式並設定 Tinybird 帳號。想在文章頁顯示觀看數,就要自己做計數器。
Q: 為什麼計數不用 Cloudflare KV?
A: KV 沒有原子操作,只能讀出數字、加 1、再寫回去,同時有多個請求時會互相覆蓋而少算;Cloudflare 官方文件也寫明 KV 是最終一致的儲存,不適合需要原子操作的用途,同一個 key 每秒只能寫 1 次。D1 可以用 SQL 在資料庫內直接加 1,並發時不會少算。
Q: 會存到讀者的 IP 嗎?
A: 不會存原始 IP。伺服器端把鹽值、IP(IPv6 取 /64 網段)、User-Agent 和文章代稱組在一起做 SHA-256 雜湊,資料庫只存雜湊值和時間,用來判斷 30 分鐘內是否重看;過期的紀錄會定期刪除。鹽值用 wrangler secret 存,不寫在程式碼裡。
Q: 超過免費額度網站會掛掉嗎?
A: 不會。Worker 只掛在 /api/views*,文章、首頁和後台都不經過它。超過 Workers 或 D1 的每日額度時,計數 API 會回錯誤,主題拿不到數字就維持隱藏,讀者只是暫時看不到觀看數,每日額度在台灣時間早上 8 點重設。
參考資料:
Ghost Docs:How To Install Ghost With Docker