GitHub Copilot 自動選模怎麼選?Efficiency、Balance、Intelligence 與計費邊界
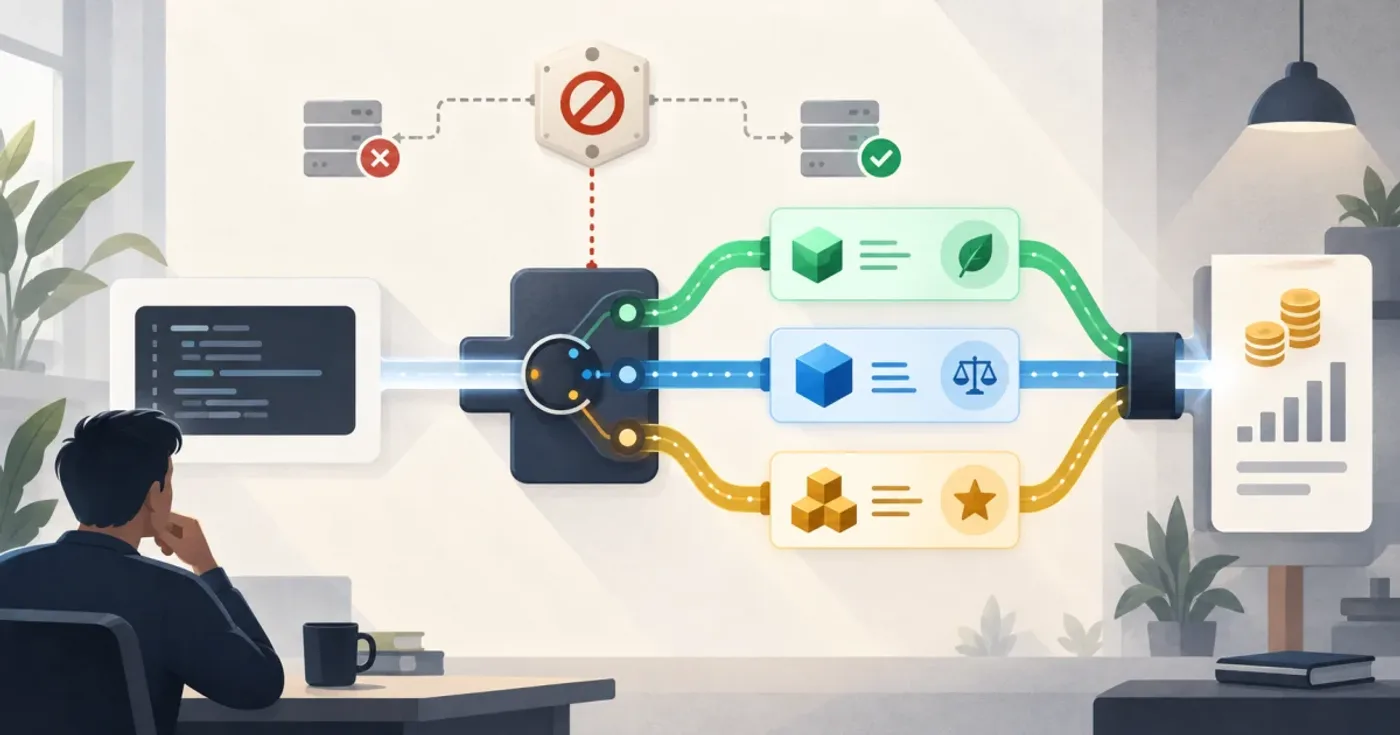
GitHub 在 2026 年 9 月 14 日替 Copilot 的自動選模加入成本與品質取向:Efficiency、Balance、Intelligence。它解決的是「讓 Copilot 依任務在模型之間路由時,要偏向低成本、折衷,還是較高品質」;它不是三個固定模型,也不是一張新的 enterprise model allowlist。
直接答案是:把 tier 當成路由偏好,把實際被選到的模型當成計費與能力的觀察單位。要設定新對話的起始模型,仍看 managed settings;要限制成員能不能使用某模型,則要看 availability policy。三件事不要混成一個設定。
三個 tier 到底改變什麼?
GitHub 的說明是:三個 tier 使用同一組可用模型,Copilot 會依每個 prompt 評估最合適的模型,再依你選的取向調整成本、品質與回應時間的權重。可以先用這個 mental model:
| 取向 | 適合的工作 | 風險與提醒 |
|---|---|---|
Efficiency | 摘要、格式整理、簡單補全、短問題 | 不代表每次都選最便宜模型;複雜 prompt 仍可能路由到較高能力模型 |
Balance | 日常 coding、測試、文件和一般除錯 | 適合當團隊預設起點,但仍要觀察實際用量與成功率 |
Intelligence | 複雜重構、跨檔案推理、疑難除錯 | 品質偏好可能提高用量成本或回應時間,不等於固定鎖定某一模型 |
這個功能目前的 tier 選擇主要出現在 VS Code、Copilot CLI 和 GitHub Copilot app;自動選模本身是否可用,還會受方案、組織 policy、地區和 client 版本影響。文件也提醒,可用模型清單會變動,因此不要在內部 runbook 把今天的模型名稱當成永久 API。
它和 managed settings 的 model 有什麼不同?
團隊最容易誤解的地方,是把兩種設定都叫「預設模型」。實際上它們處理不同層次:
| 你想控制的事情 | 應該看哪裡 | 結果 |
|---|---|---|
| 新對話一開始先選哪個模型或 auto | enterprise managed settings 的 model | 決定起始選擇;使用者是否能切換另看 policy |
| 自動選模偏向成本、品質或回應速度 | client 裡的 auto model selection tier | 改變路由偏好,不是指定一個固定模型 |
| 成員能不能看見/使用某模型 | model availability 或相關 policy | 決定可用範圍,不是路由偏好 |
| 某個 prompt 最後用了哪個模型 | 對話或 usage 詳細資料 | 才能對照實際能力與計費 |
如果你要設定 enterprise 新對話的起始值,可以先讀managed-settings.json 指定預設模型的設定邊界。當 model 設成 auto 時,它代表把新 session 交給自動選模;但 tier 仍是另一個路由偏好層,不要把它寫成 model 的替代欄位,除非 GitHub 官方文件為你的 client 提供明確 schema。
最容易踩到的計費誤區
自動選模的 tier 名稱看起來像方案級別,但 GitHub 說明的計費邏輯是:實際使用量依每個 prompt 最後選到的模型計算。因此:
- 選
Efficiency不等於所有 prompt 都按最低倍率計費。 - 選
Intelligence不等於每次都能得到某個指定旗艦模型。 - paid plan 的 10% discount 是官方目前對 auto model selection 的說明,但方案、合約和組織 billing 仍要以帳戶實際顯示為準。
- 不能只用對話數估算成本;要觀察模型使用明細、prompt 類型和失敗後重試。
導入前可以建立一份不含 prompt 內容的 usage report,至少記錄日期、client、工作類型、實際模型、成功/重試和成本。把業務機密或完整程式碼直接複製進 shared dashboard,反而會製造另一個資料治理問題。
團隊導入的建議順序
1. 先定義任務類型,不要先爭論 tier 名稱
把團隊工作分成三到五類,例如:
- 日常補全與小型測試。
- Pull request review 和文件摘要。
- 跨 package refactor。
- production incident 的 log 分析。
每一類先定義「可接受的錯誤率、延遲和成本」,再看哪個 tier 更接近目標。否則 Intelligence 很容易變成「遇到問題就選最貴」,卻沒有證明品質真的改善。
2. 先用 pilot team,保留使用者切換能力
先讓一個小型 team 在三個 client 中各跑一週,記錄:
- 每類任務的首輪成功率和人工修改時間。
- 實際模型與使用量,而不是只記錄選到哪個 tier。
- 新模型不可用、policy 阻擋或 client 不支援時的 fallback。
- 成員是否因為路由結果不穩定而重複送出相同 prompt。
如果你同時把 model availability 鎖死、禁用手動切換,又只看單一 tier 的結果,就很難知道問題來自路由、模型本身還是 policy;第一輪 pilot 應保留足夠的診斷空間。
3. 把 policy、billing 和 client 狀態分開驗證
遇到「為什麼我選了 Balance 卻沒有預期模型」時,依序檢查:
- 目前 client 是否支援 tier 選擇。
- 帳號方案、enterprise/organization policy 和地區是否允許 auto model selection。
- Auto model 的可用模型是否在當下發生變化。
- usage 詳細資料顯示實際使用哪個模型、如何計費。
- 是否把 managed setting 的起始值誤當成強制鎖定。
不要只截一張模型選單就下結論。模型選單能證明可見性,不能證明一次 prompt 的實際路由和計費。
和既有 Copilot 9 月政策一起看
自動選模只是 9 月 Copilot 管理變更的一部分;座位、個人 budget、cloud agent 和 Chat policy 仍有各自的生效日期與管理入口。若你的組織同時在做成本控管,請把本文的 auto tier 實驗和Copilot 9 月政策、計費與個人預算檢查分成兩張 checklist:一張看「模型怎麼被選」,另一張看「誰在什麼帳戶下付費」。
建議在內部文件中明確寫出這一句:
Auto model selection 的 tier 是路由偏好;model availability 是可用範圍;usage detail 才是實際模型與成本的證據。
結論:先把路由偏好和治理 policy 拆開
Efficiency、Balance 和 Intelligence 的價值,是讓團隊可以用任務需求表達成本/品質/速度的取向,而不是要求每個人手動挑固定模型。導入時先用 pilot team 量測實際模型、成功率、延遲和 cost,再決定 tier;同時保留 managed settings、availability policy 和 billing report 的獨立驗證路徑,之後模型清單變動時才不會整套治理一起失效。
常見問題
Q: 選 Intelligence 就一定使用最強模型嗎?
A: 不一定。它是自動選模的品質偏好,官方仍會依 prompt、可用模型和帳戶政策做選擇。要確認結果,應查看該次對話或 usage detail 的實際模型,而不是只看 tier 名稱。
Q: model: "auto" 和 auto model selection tier 是同一件事嗎?
A: 不是。managed settings 的 model 控制新對話的起始值;tier 控制自動路由在成本、品質與回應時間之間的偏好。它們可能一起出現,但不能互相取代。
Q: 要怎麼替團隊估算自動選模成本?
A: 用 pilot 收集實際模型和 usage detail,按工作類型比較成本、成功率與重試,而不是把 tier 直接對應到一個固定單價。正式 billing 仍以你的方案、合約和 GitHub 當下顯示為準。
參考資料:
GitHub Changelog:Configure cost and quality in Copilot auto model selection
回報錯字、失效連結,或告訴我你想看的延伸主題。