

Hugging Face harness adapters:替 Pi、OpenCode、Hermes Agent 換上 Qwen3.8-27B LoRA
本文目錄
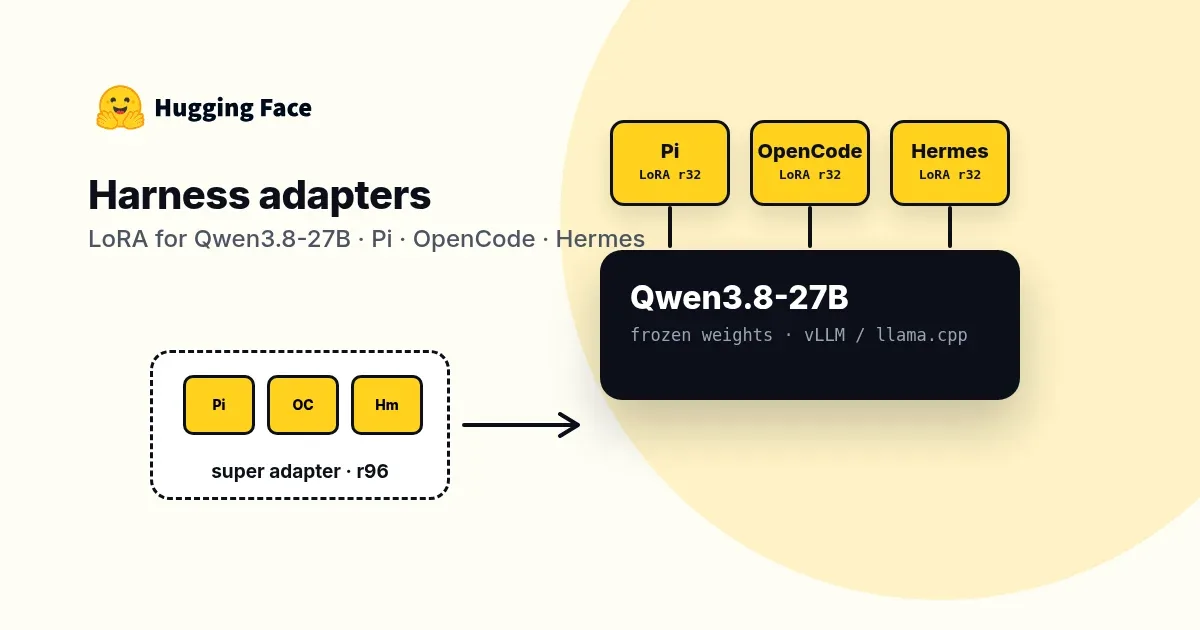
本機已經用 Qwen3.8-27B 跑 coding agent,常見的抱怨是同一個任務繞好幾圈:工具一直呼叫、token 一直燒,最後還沒做完。Hugging Face 11 月 20 日發表的 harness adapters 就是針對這件事:模型權重不動,替每個 agent harness 各訓一個 LoRA,讓模型在那個 harness 裡少繞路、一次做對。
官方給的例子:Qwen3.8-27B 搭 Pi 跑 Terminal-Bench 2.1,原本 pass@1 是 39%、每個任務平均用 2.9K tokens;掛上 Pi 專用的 adapter 後是 55%,平均 1.5K tokens。官方的解釋是模型想得比較少、工具叫得比較少,第一次就做對的比例變高。
這些 adapter、GGUF 版本和訓練任務都公開在 harness-hub 底下,授權是 Apache-2.0,和 Qwen3.8-27B 本身相同。
該下載哪一個:專用 adapter 還是 super adapter
官方釋出四個 Qwen3.8-27B 的 adapter:
| Adapter | 適用 |
|---|---|
harness-hub/Qwen3.8-27B-pi-adapted | 只用 Pi |
harness-hub/Qwen3.8-27B-opencode-adapted | 只用 OpenCode |
harness-hub/Qwen3.8-27B-hermes-adapted | 只用 Hermes Agent |
harness-hub/Qwen3.8-27B-super-adapter | 三個 harness 都會用,或要開 thinking |
super adapter 模型卡直接給了選法:只用一個 harness、關 thinking,用該 harness 的專用版;多個 harness 輪流用,或要開 thinking,用 super adapter。
理由在數字裡。關 thinking 時,專用版在六組 harness × benchmark 裡有四組贏 super adapter,差最多的是 Pi:SWE-bench Pro(最難的 51 題)專用版 64.0%,super adapter 只有 46.0%。三個 adapter 合在一起,Pi 犧牲最多。開 thinking 時情況反過來,super adapter 在六組裡有五組贏過同樣開 thinking 的原版模型,一組打平。要注意,專用版都是在 thinking 關閉的狀態下訓練的,super adapter 開 thinking 的表現只有評測過、沒有針對訓練。
另一個值得知道的結果:Pi 的專用版拿去 OpenCode 跑 Terminal-Bench 2.1,成績(44.8% → 54.0%)和 OpenCode 自己的專用版(46.4% → 52.4%)差不多,在 Hermes Agent 下也保留了約三分之二的提升。換 harness 不至於完全失效,但官方也測了不在這三個 harness 裡的 AutomationBench 商務自動化任務,Pi 與 OpenCode 版略高、合併版持平、Hermes 版低了幾個百分點,官方判斷大多在誤差範圍內。用在完全不同的任務類型,別期待一樣的提升。
用 vLLM 掛上 adapter,再讓 harness 指過去
模型卡的做法是 vLLM 載入原版 Qwen3.8-27B,再以 LoRA 掛上 adapter,對外提供 OpenAI 相容 API:
vllm serve Qwen/Qwen3.8-27B \ --enable-lora --max-lora-rank 128 \ --lora-modules qwen3.8-super=harness-hub/Qwen3.8-27B-super-adapter \ --language-model-only --enable-prefix-caching --mamba-cache-mode align \ --enable-auto-tool-choice --tool-call-parser qwen3_xml --reasoning-parser qwen3 \ --max-model-len 131072幾個容易漏的參數:
- super adapter 的 rank 是 96,vLLM 只接受特定的上限值,所以
--max-lora-rank要設 128。 - Qwen3.8-27B 是混合架構,prefix caching 要搭配
--mamba-cache-mode align,不然 agent 每一回合都會重讀整段歷史。 - chat template 預設開 thinking(模型卡建議 super adapter 開著用)。要關掉,加
--default-chat-template-kwargs '{"enable_thinking": false}'。
接著把 harness 指到 http://localhost:8000/v1,模型名稱用 --lora-modules 取的名字(上例是 qwen3.8-super)。以 Pi 為例,在 ~/.pi/agent/models.json 加一個 provider:
{ "providers": { "local": { "baseUrl": "http://localhost:8000/v1", "api": "openai-completions", "apiKey": "dummy", "models": [{ "id": "qwen3.8-super" }] } }}"api": "openai-completions" 不能省。少了它 Pi 會改用 Responses API,而 adapter 沒有在那個模式下評測過。OpenCode 寫在 ~/.config/opencode/opencode.json 的 provider,用 @ai-sdk/openai-compatible;Hermes Agent 寫在 ~/.hermes/config.yaml,provider 設 custom,而且至少要 64,000 tokens 的 context。完整範例都在模型卡上。Pi 的權限與 MCP 設定,可以對照站內的 Pi 1.0 工具權限整理。
用 llama.cpp 跑 GGUF:Mac 先看檔案大小
沒有 NVIDIA 顯示卡,可以用 GGUF 版本。模型卡的做法是下載原版的 GGUF,再以 --lora 掛上 adapter:
hf download ggml-org/Qwen3.8-27B-GGUF Qwen3.8-27B-Q8_0.gguf --local-dir .hf download harness-hub/Qwen3.8-27B-super-adapter-GGUF Qwen3.8-27B-super-adapter-lora-F16.gguf --local-dir .
llama serve -m Qwen3.8-27B-Q8_0.gguf --lora Qwen3.8-27B-super-adapter-lora-F16.gguf \ -c 131072 --port 8080 --alias qwen3.8-super指令名稱依你裝的 llama.cpp 版本為準,先用 --help 確認支援 --lora。v1.0.0 拿掉了一些舊參數,升級時要注意的地方整理在 llama.cpp v1.0.0 升級檢查。
依 11 月 22 日 Hugging Face 上的檔案清單,大小大致是:
| 檔案 | 大小 |
|---|---|
Qwen3.8-27B-Q8_0.gguf(原版) | 約 28.6 GB |
Qwen3.8-27B-Q4_K_M.gguf(原版) | 約 19.4 GB |
| super adapter LoRA(F16) | 約 0.96 GB |
| 單一 harness 的 LoRA(F16) | 約 0.32 GB |
Pi 另外有一個已經合併好的 Qwen3.8-27B-pi-Q8_0.gguf(約 28.6 GB),不用另外掛 LoRA。
這只是權重本身,131,072 tokens 的 context 還要另外吃 KV cache,記憶體實際用量要開起來看。模型卡提醒,adapter 是在 BF16 權重上訓練的,base GGUF 越接近原始精度,行為越接近評測結果;Q8_0 是合理的預設值,位元數更低的量化偏差更大,而且 GGUF 版本沒有重新評測。為了省記憶體改用 Q4,就得自己驗收效果。在 Mac 上怎麼量記憶體壓力、怎麼驗證本機 API 的工具呼叫,可以參考 Inkling 2 Mini 在 Mac 本機跑的流程。
官方數字要怎麼看
模型卡上的成績都有固定條件:每題只跑一次、100 步上限、131,072 tokens 的 context、只用文字、temperature 0.8。官方也說明,這些數字不能和 Qwen3.8-27B 自己模型卡上的分數直接比,那邊用的是別的 harness、更大的預算,SWE-bench Pro 也是全集。
還有幾個細節會影響解讀:
- 題數不多:SWE-bench Pro 只取最難的 51 題,Terminal-Bench 2.1 是 89 題。模型卡自己承認,單一列的差距多半在雜訊範圍內,把六組合併看才有統計意義。
- 部分提升來自「在預算內做完」:原版模型常常用光 100 次模型呼叫還沒做完,adapter 比較早收斂。自己比較時,兩邊要用一樣的步數上限,不然看不出差在哪。
- 官方自己提出的疑問:檢查軌跡時發現,adapter 在關 thinking 的模式下,呼叫工具前會先寫一小段像推理的文字(例如「wait、let me see」),官方稱為 reasoning leakage。他們認為結果仍然成立,但這代表關 thinking 的 adapter 不完全是「不思考」。
所以實際要不要換,最可靠的方式是拿自己 repo 裡的真實任務,原版和 adapter 各跑一輪,比完成率、工具呼叫次數和 token。站內的 自架模型接 coding agent 驗收方式 有一套可以直接套的測試項目。
想用自己的任務訓練:先看硬體門檻
官方把整套流程公開了:任務資料集 harness-hub/agentic-coding-envs(871 題,來自 35 個 repo)、用 openenv validate 驗證任務、TRL 的 AsyncGRPOTrainer 做 RL,rollout 在 Hugging Face Jobs 的沙箱裡跑,再用 safeagents 擋掉訓練中的危險工具呼叫。
門檻在硬體:每個 harness 的 adapter 用了 2 張 NVIDIA B200,一張跑 vLLM、一張跑訓練。LoRA 設定是 r = 32、alpha = 64,學習率最後定在 2e-5。官方也提到,任務太簡單(每次都過)或太難(每次都失敗)都學不到東西,他們只留原版模型「有時過、有時不過」的題目。自己準備任務時,這個篩選比堆題數重要。
只是想讓本機的 coding agent 好用一點,直接下載現成的 adapter 就夠了;要自己訓練,得先有能長時間租用資料中心等級 GPU 的預算。
參考資料:
Hugging Face:Introducing harness adapters
Hugging Face:Qwen3.8-27B super adapter 模型卡