Laya 文章自動貼標實測:Noul 與分層 Choice 差多少?
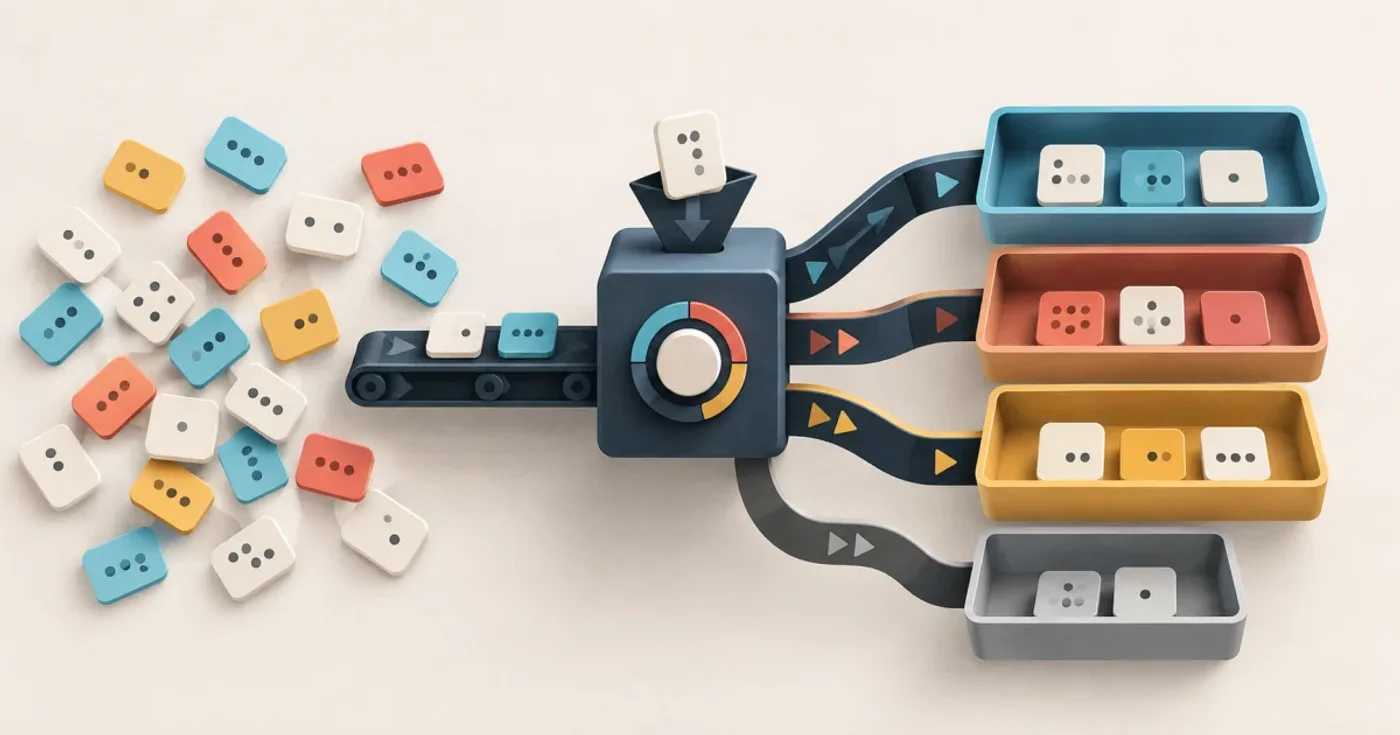
文章自動貼標看起來正好符合 Laya 的能力:輸入文章內容,從固定 Tag 集合挑出 3~5 個結果,不需要生成長篇文字。實際接進內容庫後,第一版卻只得到 0.3158 的 micro F1;把門檻從 0.5 往上調,也沒有變成可用的自動貼標器。
真正的問題不是「Laya 能不能分類」,而是把多標籤任務建模成什麼問題。這次小型離線測試比較 flat Noul、只改 Prompt 的三層 Choice,以及由既有分類規則約束的 hierarchical Choice。結果顯示:分層方法在規則完整涵蓋的控制組中,把 micro F1 從 0.3333 提高到 0.7778;分類規則沒覆蓋的文章,效果反而更差。
測試怎麼避免把答案餵給模型
測試使用 Laya 0.3.4 的 multilingual checkpoint,在 Apple Silicon 的 CPU 環境執行。資料來自四篇既有繁體中文技術文章,公開內容只保留聚合指標,不保留站名、文章標題、路徑或完整 Tag 組合。
每篇文章送給模型的 state 只包含:
- 標題與 description。
- Markdown 小標題。
- 移除 frontmatter、程式碼區塊與格式符號後,最多 2,000 字元的正文。
原始 Tag 只在推論完成後作為 expected_tags,不會出現在 state。候選則從內容庫已使用過的 Tag 產生,先依文章中的字面命中與全站使用頻率排序,再保留前 20 個。除了 precision、recall 與 F1,測試也單獨計算 candidate recall,避免把「正確 Tag 根本沒進候選」誤判成模型選錯。
這個流程維持 shadow mode:只輸出 JSON 報告,不修改任何文章。若你還不熟悉 Laya 的三種 typed decision,可以先讀 Laya 本機模型的安裝、用法與限制。
Flat Noul 為什麼容易選出一堆相關標籤
第一版把每個候選都變成獨立 Noul:
questions[tag] = { "type": "noul", "instructions": ( f"Is {tag!r} one of the main subjects of this article, " "rather than a passing mention?" ),}達到 threshold 0.5 的項目再依機率排序,最多取 5 個。兩篇初始樣本的 candidate recall 都是 1.0,代表人工 Tag 全部在候選裡;但 micro precision 只有 0.3000、recall 為 0.3333,最後 F1 是 0.3158。
問題出在「每題獨立」。一篇談 AI 開發工具與設定管理的文章,可以同時讓 CLI、自動化、疑難排解、最佳實踐等標籤看起來成立。模型不需要在它們之間競爭,於是大量語意相鄰的 Tag 都得到高分,真正的 Tag 反而被擠出 Top 5。
調整門檻也沒有解決。這批結果在較寬鬆條件下最高可以得到約 0.51 的 F1,但代價是一次選出 20 多個 Tag,已經違反原本 3~5 個標籤的內容規則。
只把 Prompt 寫成三層仍然不夠
下一步把候選分別問成「主要領域」、「具體技術/產品」與「具體概念/內容型態」三個 Choice,但每一題仍看到相同的 20 個候選。
這個版本幾乎沒有改善。三層的候選排序高度相似,模型可能在「主要領域」選到產品名稱,也可能在「具體概念」繼續選同一個工具。層級只存在 instruction 裡,程式並沒有真正限制每層能看到什麼。
這是這次測試最重要的失敗:分類規則寫在人看得懂的文件裡,不等於模型已經得到機器可執行的 taxonomy。
把既有分類規則變成 Choice 約束
第三版才真正使用既有規則。基礎候選仍然相同,但進入模型前依文件中的清單分組:
主要領域:最多 1 個具體技術或產品:最多 2 個具體概念或內容型態:最多 2 個每一層只會看到屬於自己的候選,並加入「此層沒有合適標籤」選項。合併時去除重複值,總數不超過 5 個。
在兩篇所有人工 Tag 都能被規則清單涵蓋的控制文章中,結果如下:
| 策略 | micro precision | micro recall | micro F1 | candidate recall |
|---|---|---|---|---|
| Flat Noul | 0.3000 | 0.3750 | 0.3333 | 0.8750 |
| Hierarchical Choice | 0.7000 | 0.8750 | 0.7778 | 0.8750 |
把候選上限從 20 提高到 40 後,candidate recall 升到 1.0,但 hierarchical Choice 的 F1 仍是 0.7778;Flat Noul 則降到 0.1111。候選增加可以找回漏掉的正確答案,也會把更多干擾項目送進模型,兩者不能混為一談。
規則漂移會讓分層方法失效
分層 Choice 並不是所有樣本都變好。另一組文章只有約三分之一的人工 Tag 已列入規則清單,hierarchical Choice 的 F1 從 flat Noul 的 0.3158 降到 0.2222。
這組結果揭露的不是模型退步,而是 taxonomy drift:內容庫持續新增產品、工具與概念 Tag,核心規範卻沒有同步替它們定義層級。在這次盤點中,文件清單涵蓋不到一半的 Tag 使用次數,不同 Tag 的涵蓋比例更低;完整落在清單內的文章只占極少數。
若直接把這份不完整清單變成模型限制,未登記的正確 Tag 一定選不出來。反過來,若完全不限制,模型又會回到大量相關標籤同時高分的狀態。
因此真正需要維護的是一份 versioned Tag registry,而不是繼續修改 Prompt:
- 每個 Tag 所屬的 layer。
- 正式名稱、別名與棄用狀態。
- 每層可選數量與互斥關係。
- 什麼情況允許 none 或交給人工。
- 新 Tag 如何加入、何時回頭重跑 holdout。
Laya 適合當貼標器嗎?
這次結果支持一個有條件的答案:適合當「受約束的候選選擇器」,不適合在缺少完整 taxonomy 時直接接管文章 Tag。
Laya 官方模型卡也提醒,base checkpoint 的 typed-decision zero-shot 表現接近基準線,並明確把它定位成需要專門化的快速底座;高選項數 Choice 還會受到 option prompt 預算影響。模型原始機率也可能過度自信,需要用自己的資料重新校正。官方 README 的 Honest Limits和這次小樣本觀察一致:typed output 解決的是介面與速度,不會自動理解每個內容庫的分類政策。
如果要往正式流程推進,較安全的順序是:
- 先把現有 Tag 分層整理成可版本控制的 registry。
- 準備至少 100~300 篇人工確認的 holdout,中文與英文分開評估。
- 讓 Laya 在 shadow mode 記錄候選、機率與人工結果,不寫回文章。
- 依 layer 分別觀察 precision、recall、校正與 none 的錯誤。
- 只讓低風險、高 precision 的層級先自動化,其餘交給人工或較強模型。
這個分工也適用於 Jev。兩者都適合答案空間已知的小判斷;要了解這類模型的介面邊界,可參考 Jev 的用途、限制與成本。若流程會進一步控制 Agent 或模型路由,還要加入可驗證完成條件,不能只看模型有沒有回傳合法 JSON。
常見問題
Q: Laya 可以直接替文章自動加 Tag 嗎?
A: 技術上可以,但不建議一開始就寫回文章。先固定 Tag registry、層級配額與候選產生方式,再用既有人工 Tag 做 shadow-mode 回測。只有在特定層級累積足夠 precision、錯誤代價可控,而且 none/人工 fallback 已驗證後,才適合逐步開放自動化。
Q: Flat Noul 和 Choice 應該怎麼選?
A: 判斷彼此獨立,而且同時成立是合理結果時,使用 Noul;標籤會互相競爭、每層有數量限制時,使用 Choice。文章貼標通常同時包含多層與多選,較實用的做法是先由程式分層,再在每層內使用 Choice,而不是把所有 Tag 攤平成數十個 Yes/No。
Q: 加入 none 選項就能避免多貼標嗎?
A: 不一定。這次測試加入「此層無合適標籤」後,模型仍可能把看似合理的概念 Tag 排在 none 前面。none 也需要用自己的標註資料驗證與校正;高影響流程不能把它當成天然可靠的拒答機制。
參考資料: