557 字
3 分鐘
Qwen-Image-2.1 生圖文字準確嗎?六張本機樣本的觀察
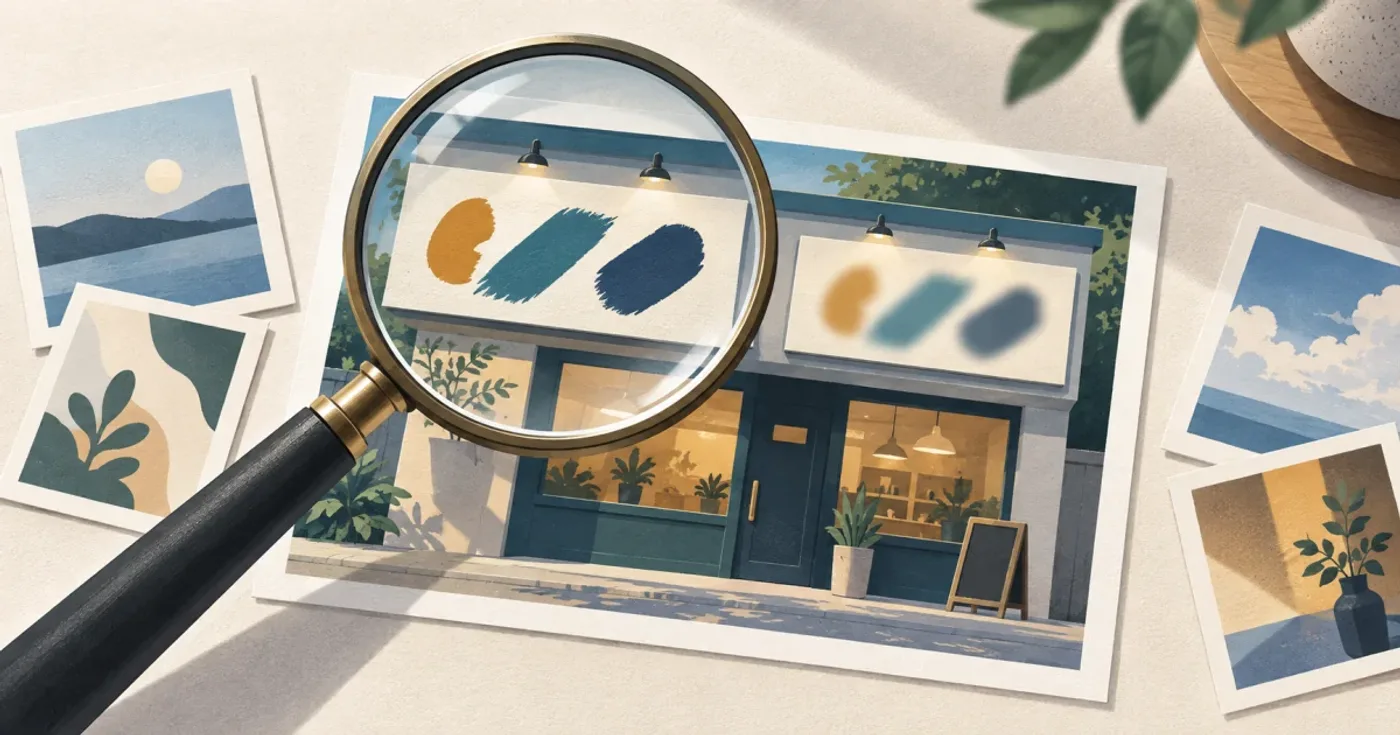
用 Qwen-Image-2.1 做含字圖片時,真正要檢查的是輸出上的字,而不是提示詞寫得多明確。這次本機產出六張圖片,其中有短中文、短英文及較長英文文字的場景。
測試環境是 2026 年 9 月的 MacBook Air M3 16GB,使用 mflux 0.20.0、Qwen-Image-2.1 的社群 MLX 4-bit 權重,正式尺寸用 40 步、guidance 1.0。耗時與記憶體另見本機出圖實測;部署指南則整理了其他推論路線。
這六張圖能說什麼
短中文字在兩張相關樣本中可辨,較大的字也能正確呈現。短英文在一張樣本中清楚可讀;較長的英文文字則出現部分模糊,仍需人工檢查。這些是目視觀察,沒有盲評、OCR 分數或同一提示詞的多 seed 對照。
因此不能從這批結果推論「中文一定比英文好」,更不能說所有招牌文字都準確。不同圖片的字數、字體大小、背景與提示詞本來就不相同。尤其兩張中文樣本太少,剛好成功也可能只是題材或構圖較容易。
需要可用文字時,怎麼驗收
先把文字要求縮成一句,固定模型版本、量化檔、圖片尺寸、步數與 seed。至少檢查以下幾件事:字有沒有漏、筆畫是否錯、詞序是否被改、縮小到實際投放尺寸後能不能讀。若要比較中英文或長短字串,應使用相同構圖與多個 seed,逐張記錄錯字數;單張成功不能代表成功率。
如果文字是品牌名稱、價錢、活動日期或法律聲明,生成圖仍要經人工校對。這次實測只能支持「短字串有成功案例,較長英文有失真案例」,不足以支持直接把生成文字當成可交付內容。
注意看到只談出圖效果的介紹時,記得另外核對授權。Qwen-Image-2.1 官方授權限非商業研究與評估;若要將模型用於商業專案,須另行取得授權。
參考資料:
Qwen-Image-2.1 生圖文字準確嗎?六張本機樣本的觀察
https://laplusda.com/posts/qwen-image-2-1-text-rendering-small-sample/