Sakana MASS 自我改進研究:多 Agent 互評、訓練與基準怎麼看
把同一個模型開成多個 Agent,讓它們分工、互評,再要求「下一次做得更好」,有沒有真的讓模型學會新能力?先看改變的是工作流程,還是模型權重;再看進步由誰驗收。 多輪對話可以改善當次結果,卻不代表更新了下一次呼叫所用的模型。
Sakana AI 與 UC Berkeley 的 MASS(Multi-Agent Self-Supervision)研究,把這兩件事接成迴圈:官方公告於 2026 年 10 月 12 日發布,arXiv v1 則標示 10 月 8 日。這篇依論文、作者說明與公開 repository 分析,沒有執行模型推論、LoRA 訓練或重跑基準。
MASS 的兩層迴圈,各自改了什麼
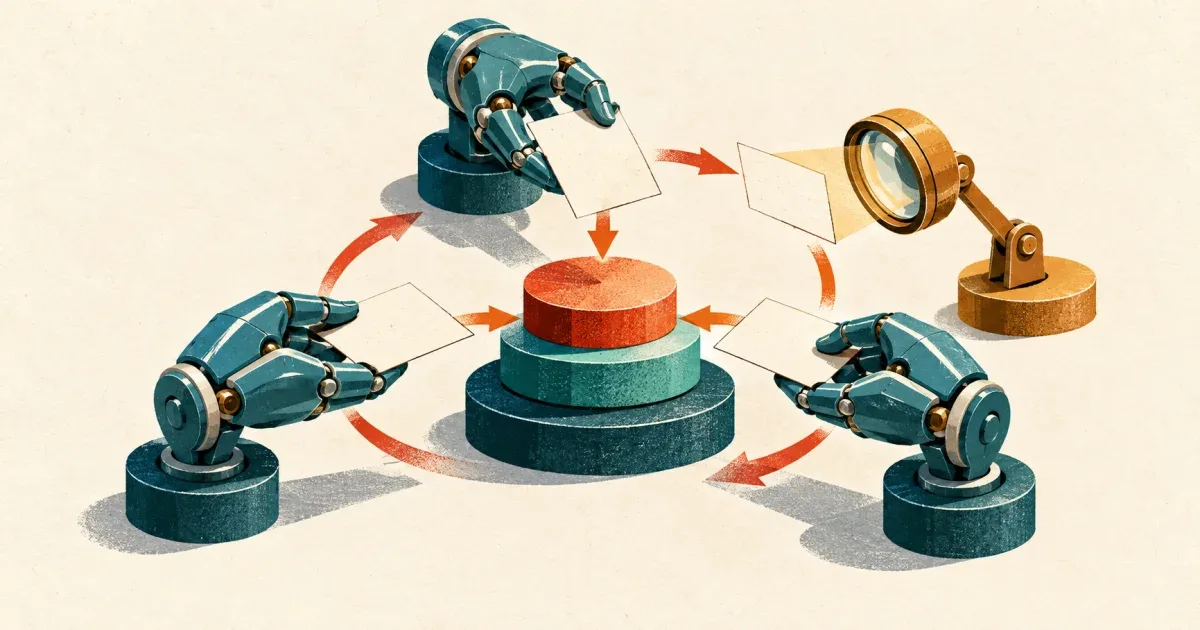
依論文方法章節,內層先固定模型權重。模型執行候選工作流程,另一個相同模型的角色評估產物,優化者再依回饋調整分工與資訊交接。這一步得到的是文字形式的工作流程。
外層才選取執行軌跡做 supervised fine-tuning,更新共用模型權重。下一輪的執行者、優化者與迴圈內評估者,都改用更新後模型。軌跡包含協調者與子 Agent 的訊息、工具呼叫及結果;訓練時,工具結果是上下文,模型輸出才是學習目標。
這提供了一個判讀方法:若產品只保存 memory、修改提示或選擇較好的候選答案,就記錄它實際改動的項目。要宣稱重現 MASS 的模型學習,還需有訓練資料、權重更新與新 checkpoint 的證據。
同一模型自評,研究如何量進步?
MASS 的迴圈內評審會影響工作流程和訓練資料選擇;作者另外使用外部模型評估已完成產物,這些判斷不回饋給 MASS。作者的研究說明將兩者用途分開。外部評審提供不同觀點,仍是模型判斷,不能直接等同科學結論已經獲得獨立實驗確認。
若團隊想採用類似方法,應保存三份能對上的資料:選中的工作流程、產出的實際檔案,以及評審使用的規則和判斷。只有「評審說更好」的文字,無法讓下一位維護者檢查產物是否真的滿足任務。
例如資料分析任務可以要求程式碼、資料切分記錄、可重跑的計算結果和來源路徑。評審偏好可以用來排序;計算能否重現、測試資料是否混入訓練,則另外檢查。這是依研究設計延伸的驗收建議,本文沒有替特定產品完成驗證。
「每 Token 分數提高」不等於程式能力全面提高
官方公告的 1.2–1.6 倍,指兩輪後在四個研究基準上的 score per output token 相對基礎模型提升。它包含品質與輸出長度兩個因素,不能換算成完成時間、總訓練成本或 API 帳單節省比例。
公開 repository列出的原始分數也顯示任務差異:
| 基準與量尺 | 基礎模型 | 兩輪 MASS 後 |
|---|---|---|
| ScienceAgentBench,百分比 | 28.8 ± 1.5 | 31.7 ± 2.0 |
| MLR-Bench,原始量尺 | 1.71 ± 0.08 | 2.25 ± 0.06 |
| Terminal-Bench 2.0,通過比例 | 0.375 ± 0.022 | 0.352 ± 0.017 |
| SWE-bench Verified,通過比例 | 0.626 ± 0.015 | 0.611 ± 0.006 |
這是作者公布的三次 trial 摘要;量尺不同,不能把欄位相加或直接比較高低。後兩項沒有跟著提高,因此也不能從研究任務的改善推論成一般軟體工程能力全面提升。
實際決策應回到要交付的工作。如果目標是修專案測試,就用固定的修復任務、相同工具權限和執行預算評估;如果目標是寫研究報告,還要分開看「有交出報告」與「內容正確」。多產生一份檔案,不等於多完成一項有效研究。
開源程式可用,還要檢查哪些重現缺口
本次檢閱的 repository commit 為 fb403581bed2c974b3f99e7236224169da643079。README 指定基礎模型為 Qwen3.6-27B,coding-agent runtime 為 qwen-code 0.20.0,並公開工作流程搜尋、軌跡選取和訓練管線。
但同一份 README 也寫明:隨附 MLR-Bench 設定是較早的 12-task 子集;部分完整基準設定或 adapter 沒有收錄,RHI driver 與論文演算法的比較方式也有差異。下載程式後跑通小測試,只能證明該測試通過,無法自動取得論文表格的重現資格。
評估重現方案時,可以先要求對方交代「要重現哪一列結果」,再核對該列的模型 revision、任務清單、工具版本、評審設定、trial 數與失敗處理。缺少一項時,就把結論縮到實際能重現的範圍。
MASS 最值得借用的工程觀念,是讓分工有明確交付物,讓進步保留可檢查的證據。同一模型的共同盲點也可能一路進入評審與訓練,驗收機制需要持續接受外部檢查。若正在設計日常 coding agent 的驗收,可接著看 AI Agent 的執行迴圈與完成判定;這類工作流程改善可以先做,不必宣稱已經完成模型自我訓練。
參考資料:
Sakana AI:Recursive Self-Improvement through Collective Intelligence